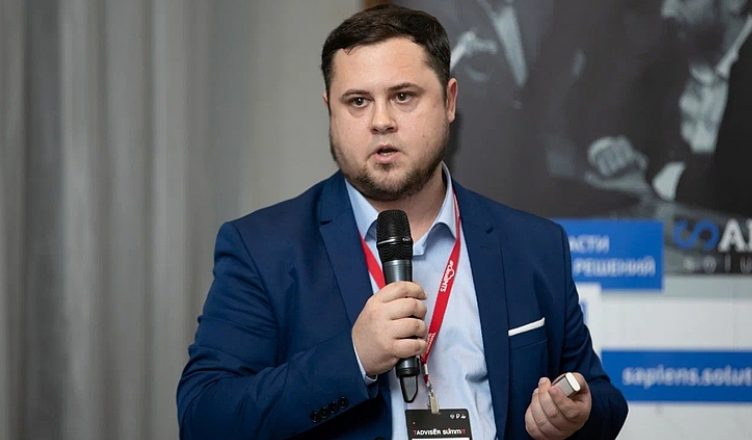
Андрей Бугаенко, автор книги «Искусственный интеллект в анализе бизнес-процессов и Process Mining», в эксклюзивном интервью ProcessMi рассказал, как ИИ меняет процессную аналитику, и почему компаниям уже недостаточно проводить разовые исследования процессов.
Андрей работает с процессной аналитикой 17 лет. Он развивал применение машинного обучения в Process Mining в Сбере, а сейчас занимается созданием ИИ-агентов в Яндексе. Мы поговорили о том, что вошло в его книгу, каких результатов бизнес ждет от Process Mining сегодня и какую роль в анализе процессов могут взять на себя ИИ-агенты.
— Вы давно работаете на стыке Process Mining и искусственного интеллекта. Как вы вообще пришли в эту область и чем занимаетесь сегодня?
С процессной аналитикой я связан 17 лет. Начинал с описания процессов в BPMN и внедрения ERP-систем. Примерно в то же время, обучаясь в аспирантуре, познакомился с методами машинного обучения. Долгое время эти направления в моей работе существовали параллельно.
В 2016 году я прочитал книгу Вила ван дер Аалста и задумался о том, как применять машинное обучение в Process Mining. Сначала развивал эту идею как собственный проект, затем — в команде Data Science департамента финансов Сбера. Позже возглавил команду специалистов по ИИ в направлении Process Mining, а с 2023 года руководил всем направлением внутреннего применения Process Mining в Сбере — и процессными аналитиками, и дата-сайентистами.
В прошлом году я перешел в другую компанию, но продолжил заниматься применением ИИ в Process Mining. Быстро развивались большие языковые модели и ИИ-агенты, появлялись новые задачи. Сейчас по своей основной работе я создаю ИИ-агентов, в том числе для анализа бизнес-процессов.
— За это время Process Mining сильно изменился. Что сильнее всего изменилось в самой технологии и в вашем отношении к ней?
Поначалу и довольно долгое время главной задачей Process Mining было как можно точнее восстановить граф процесса с помощью алгоритмов. Затем внимание сместилось на прикладные возможности платформ: удобные фильтры, BI-виджеты, работу с несколькими процессами. Все это помогало аналитикам быстрее находить неэффективности.
Но уже семь-восемь лет назад было понятно, что следующий шаг — сократить объем ручной работы аналитика. Вместо того чтобы самостоятельно переключать фильтры и искать отклонения на графе, он должен получать результаты анализа от ИИ и проверять их. Тогда мы уже разрабатывали функции, которые автоматически выявляли неэффективности с помощью машинного обучения, поиска аномалий, обучения с подкреплением и обработки естественного языка.
Большие языковые модели и построенные на их основе ИИ-агенты сняли часть прежних технических ограничений и открыли новые возможности для такого анализа. В этом направлении технология развивается и сейчас.
— А как из этого опыта выросла идея книги? В какой момент появилась мысль, что пора собрать все в одном месте?
Книгу я начал писать около восьми лет назад, но работа над ней требовала времени, а технологии продолжали меняться. В сентябре прошлого года я наконец смог вернуться к рукописи. Перечитал написанное и понял, что не хочу публиковать его в таком виде: значительная часть материала устарела, кое-что рассказывал на конференциях. Кроме того, на многие вопросы читатель теперь может получить ответ у языковой модели. Я удалил все, что написал до сентября 2025 года, и начал заново.
В новой книге я сосредоточился на применении больших языковых и мультимодальных моделей, а также ИИ-агентов. Другие методы машинного обучения включил только там, где удалось предложить решения лучше тех, что я реализовывал раньше.
— Когда вы садились ее писать, уже было четкое понимание, какой она должна получиться, или структура складывалась по ходу?
Когда осенью прошлого года я вернулся к работе над книгой, структура и содержание уже сложились голове. Оставалось изложить их на бумаге. В феврале я сдал рукопись в редакцию, но пока шли редактура и корректура, продолжал обновлять материал. В основном изменения касались архитектуры решений и схем: технологии успели сделать еще один шаг вперед.
— Что вам было особенно важно включить в книгу — из того, что обычно остается за рамками статей, докладов и кейсов?
Для меня были важны две вещи. Первая — личный опыт внедрения и применения ИИ в Process Mining, включая сложности, о которых обычно не рассказывают. Надеюсь, он поможет тем, кто развивает это направление в своей компании, избежать ошибок, которые когда-то совершал я. Такой опыт нельзя получить, просто задав вопрос языковой модели: она не знает, с чем я столкнулся на практике.
Вторая — решения на основе новых технологий. Я верю, что их применение поможет Process Mining в России выйти на новый уровень.
— Если посмотреть на Process Mining в России сегодня — это уже зрелый рынок или он все еще находится в стадии формирования?
Рынок неоднороден. У крупнейших компаний уже накоплен опыт и есть специалисты, способные внедрять ИИ в Process Mining и решать задачи импортозамещения. В малом и среднем бизнесе вопрос компетенций очень актуален. При этом с развитием и ростом доступности больших языковых моделей порог входа снижается. Думаю, вскоре запуск Process Mining вместе с ИИ станет массовой практикой.
Мое мнение, что Россия в этом направлении не уступает другим странам, а в чем-то их превосходит.
— Как изменились компании, которые приходят в Process Mining? С какими запросами они приходили несколько лет назад и с какими приходят сейчас?
Раньше провести несколько исследований и найти неочевидные неэффективности уже считалось серьезным результатом. Сейчас компании хотят поставить анализ процессов на поток: исследовать десятки и даже сотни процессов. Снизился порог входа, стало проще и быстрее показать первые эффекты. Поэтому все больше компаний начинают применять Process Mining вместе с ИИ.
– Где, по вашему опыту, компании чаще всего ошибаются в ожиданиях от Process Mining?
Я бы отметил проблемы с качеством данных, отсутствием сквозных идентификаторов для восстановления процесса от начала до конца, методологические разногласия внутри компании. Это сложные, но решаемые задачи: на них нужны время и ресурсы. Новые технологии уже помогают восполнять пробелы в данных. Например, если часть работы сотрудник выполняет вне компьютера, Task Mining не может ее зафиксировать. Теперь такие действия можно записать на камеру, обработать видео с помощью мультимодальной модели, получить описание операций и дополнить им журнал событий из информационной системы. Так появляется возможность восстановить более полную картину процесса.
Сложнее, когда руководители изначально не понимают, какую пользу даст Process Mining. Технология помогает обнаружить проблему, но устранять ее пока должен человек. Думаю, по мере распространения Process Mining понимание его возможностей будет расти, а в будущем мы придем и к автоматическому устранению неэффективностей.
— Сейчас Process Mining все чаще обсуждают вместе с ИИ, цифровыми двойниками и автоматизацией. Как вам кажется, во что он в итоге вырастет?
Для многих руководителей анализ бизнес-процессов с помощью ИИ пока звучит как далекое будущее. Думаю, через несколько лет это станет привычной практикой, а еще через десятилетие применение Process Mining без ИИ будет казаться устаревшим.
В более далекой перспективе изменится и работа процессных аналитиков. Развитие цифровых двойников позволит обнаруживать потенциальные неэффективности еще до того, как они возникнут в реальном процессе. Аналитики и владельцы процессов будут задавать цели и требования к процессу, а ИИ — предлагать варианты его устройства и перестраивать его с учетом этих требований. Человеку останется выбрать подходящий вариант или проверить предложенное решение.
ИИ-агенты смогут адаптировать ERP, CRM и другие системы под изменившийся процесс. В результате бизнес-системы будут непрерывно меняться вместе с процессами. При этом, как я предполагаю, потребность в проверке каждого действия ИИ человеком постепенно будет снижаться.